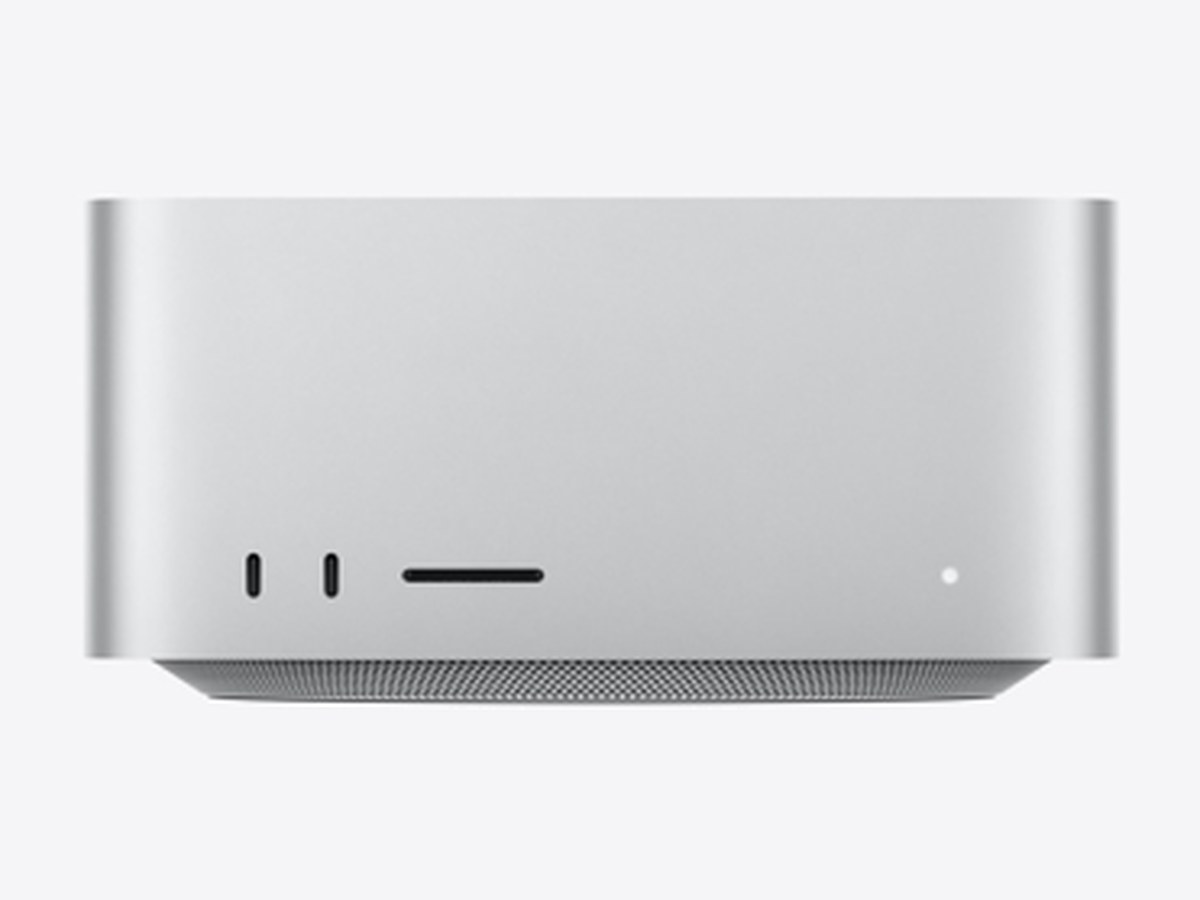
Khi một mô hình AI mở quá lớn cho bộ nhớ của một máy, có hai đường: thuê GPU trung tâm dữ liệu, hoặc ghép nhiều máy nhỏ lại thành một cụm. Từ macOS 26.2, Apple hỗ trợ RDMA qua Thunderbolt 5 giữa các máy Mac, và từ tháng 8/2026 hãng giới thiệu thẳng khả năng ghép cụm trên Mac Studio M5 Ultra. Bài này giải thích cụm Mac Studio hoạt động ra sao, cần bao nhiêu cáp và cổng, phần mềm nào chạy được (MLX phân tán, exo), số liệu thử nghiệm công khai nói gì, giá hai gói AI Cluster 2 và AI Cluster 4 của Namtech — và quan trọng không kém: khi nào doanh nghiệp không cần cụm. Mọi thông tin kỹ thuật đều dẫn nguồn, tra cứu ngày 24/09/2026.
Tóm tắt nhanh
- Cơ chế: từ macOS 26.2, RDMA qua Thunderbolt 5 cho phép các máy Mac trao đổi dữ liệu với độ trễ thấp; MLX dùng tính năng này qua backend JACCL, còn backend ring chạy qua TCP là phương án dự phòng.
- Đi dây: JACCL chỉ hỗ trợ nối đủ mọi cặp máy bằng cáp Thunderbolt 5 — 4 máy cần 6 cáp, mỗi máy dùng 3 cổng. Chưa có switch Thunderbolt 5.
- Bật tại chỗ: RDMA phải bật bằng lệnh
rdma_ctl enabletrong chế độ Recovery, không bật từ xa được. - Phần mềm: MLX phân tán (có sẵn trong MLX) và exo — công cụ mã nguồn mở ghép cụm, hỗ trợ RDMA qua Thunderbolt 5 từ bản 1.0.
- Giá phần cứng Namtech (đã gồm VAT): AI Cluster 2 = 615.600.000₫ (2 × M5 Ultra 256GB); AI Cluster 4 = 1.231.200.000₫ (4 máy). Phần mềm và bảo trì báo giá riêng.
- Đa số không cần cụm: một Mac Studio M5 Ultra 96GB hoặc 256GB đã đủ cho phần lớn nhu cầu AI nội bộ; cụm chỉ đáng khi mô hình vượt bộ nhớ một máy.
- RDMA qua Thunderbolt có từ macOS 26.2; backend JACCL cho độ trễ truyền thông thấp hơn backend ring một bậc độ lớn — theo tài liệu MLX.
- exo công bố tăng tốc tensor parallel tới 1,8 lần với 2 máy và 3,2 lần với 4 máy — theo README của exo trên GitHub.
- Cụm 4 Mac Studio M3 Ultra (đời chip trước; dòng hiện hành là M5 Ultra), tổng 1,5TB bộ nhớ hợp nhất, chạy Qwen3 235B đạt 32 token/giây với exo — số của bên thứ ba, Jeff Geerling, 18/12/2025.
- Apple nêu cụm 4 Mac Studio nhanh hơn tới 3 lần một máy khi suy luận AI — MacRumors, 26/08/2026.
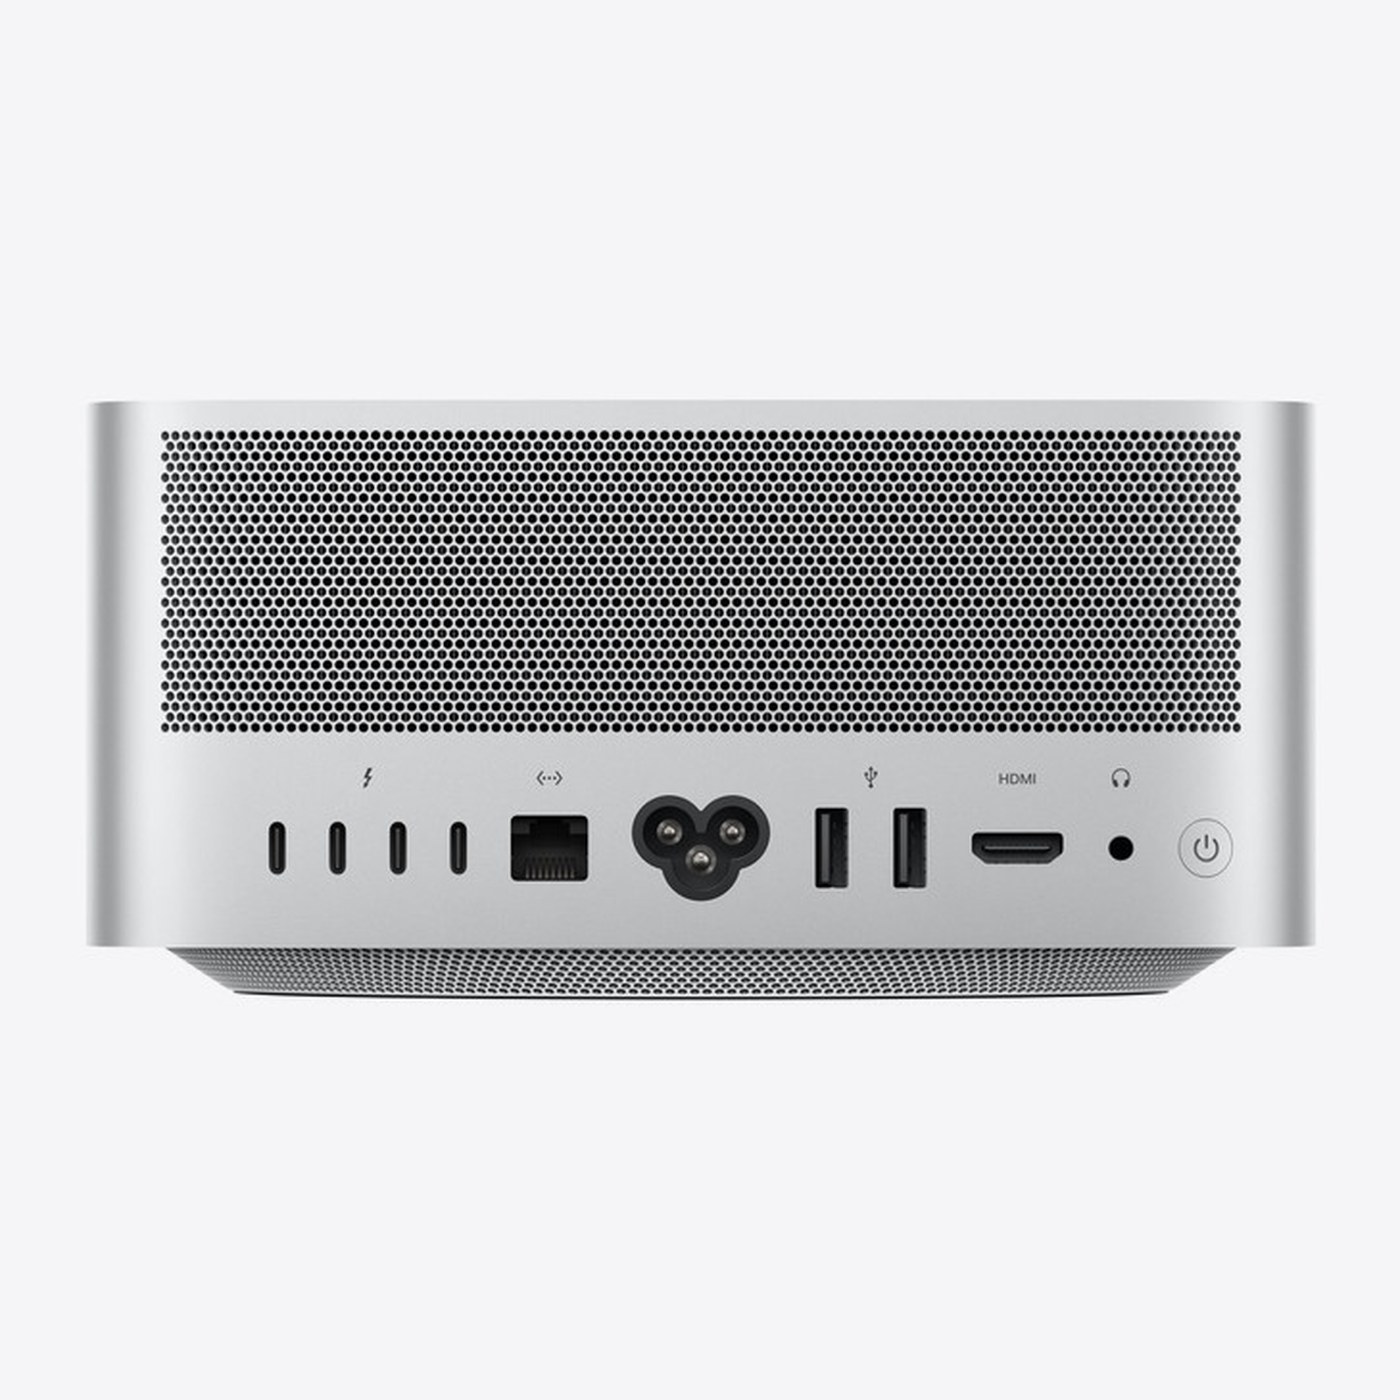
- Mac Studio M5 Ultra có 6 cổng Thunderbolt 5 (4 sau, 2 trước), M5 Max có 4 (theo thông số Apple).
RDMA qua Thunderbolt 5 là gì?
RDMA (remote direct memory access) là cách để một máy đọc hoặc ghi thẳng vào bộ nhớ của máy khác mà không phải đi vòng qua ngăn xếp mạng TCP/IP thông thường, nhờ đó độ trễ giảm mạnh. Theo tài liệu phân tán của MLX, bắt đầu từ macOS 26.2, RDMA qua Thunderbolt đã có sẵn và cho phép truyền thông độ trễ thấp giữa các máy Mac có Thunderbolt 5; MLX cung cấp backend JACCL dùng tính năng này và đạt độ trễ truyền thông thấp hơn backend ring một bậc độ lớn.
Vì sao độ trễ quan trọng với AI? Khi một mô hình được chia cho nhiều máy, mỗi token sinh ra đều cần các máy trao đổi kết quả trung gian với nhau. Nếu mỗi lần trao đổi chậm, cả cụm phải chờ, và thêm máy có khi còn chậm hơn. Tài liệu MLX ghi rõ JACCL là backend cần thiết cho những kỹ thuật như tensor parallelism — chia từng lớp của mô hình ra nhiều máy để các máy cùng tính một token. Blogger công nghệ Jeff Geerling, người thử một cụm Mac Studio do Apple cho mượn, viết trong bài thử nghiệm của mình rằng RDMA hạ độ trễ truy cập bộ nhớ từ khoảng 300 micro giây xuống dưới 50 micro giây.
Backend ring vẫn có vai trò. Theo MLX, ring không phụ thuộc thư viện bên thứ ba nên luôn sẵn sàng, chạy qua socket TCP và thường nhanh hơn MPI; các máy được nối thành vòng, mỗi máy chỉ nói chuyện với hai máy kề bên. Mục đích chính của ring là tận dụng các vòng Thunderbolt để có băng thông cao hơn Ethernet. Nói ngắn gọn: JACCL là đường nhanh khi RDMA đã bật và dây đã nối đủ; ring là phương án dự phòng khi chưa bật được RDMA hoặc cấu trúc dây không đủ điều kiện.
Apple cũng chính thức hoá hướng đi này. Trong thông cáo ra mắt Mac Studio M5 Max và M5 Ultra tháng 8/2026, hãng viết rằng người dùng và nhóm làm việc có thể ghép nhiều Mac Studio qua Thunderbolt 5 và RDMA để tạo một vùng bộ nhớ dùng chung lớn, và cụm 4 máy cho tốc độ suy luận AI nhanh hơn tới 3 lần một máy — MacRumors đưa tin lại ngày 26/08/2026. Chú thích trên trang Mac Studio của Apple cho biết phép thử dùng máy tiền sản xuất M5 Ultra 36 CPU/80 GPU, 512GB, đo thời gian tóm tắt một prompt 32 nghìn token với mô hình dày 72 tỷ tham số qua mlx-lm, so một máy với cụm 4 máy nối đủ mọi cặp. Đó là số của hãng trong điều kiện của hãng, không phải cam kết cho mọi tải.
Cần bao nhiêu cáp và cổng Thunderbolt 5?
Mỗi cặp máy trong cụm cần một sợi cáp Thunderbolt 5 nối trực tiếp, nên số cáp tăng rất nhanh theo số máy: n máy cần n(n−1)/2 sợi cáp và mỗi máy dùng n−1 cổng. Lý do là MLX ghi rõ backend JACCL chỉ hỗ trợ cấu trúc nối đầy đủ — phải có cáp Thunderbolt nối trực tiếp mọi cặp máy. exo cũng đặt cùng điều kiện: máy muốn tham gia cụm RDMA phải nối với tất cả máy còn lại, và cáp phải hỗ trợ Thunderbolt 5.
Không có đường tắt bằng switch. Jeff Geerling viết rằng theo những gì ông biết, switch Thunderbolt 5 chưa tồn tại, nên không thể cắm nhiều Mac vào một switch trung tâm — phải nối mỗi máy với mọi máy khác. Ông cũng ghi nhận thời điểm cuối 2025 mới thấy cụm RDMA tối đa 4 máy, dù Apple cho biết cả năm cổng Thunderbolt 5 của Mac Studio M3 Ultra đều hỗ trợ RDMA. README của exo thêm một lưu ý đáng chú ý: trên Mac Studio, không dùng được cổng Thunderbolt 5 nằm cạnh cổng Ethernet cho RDMA.
| Số máy trong cụm | Số cáp Thunderbolt 5 | Cổng TB5 cần trên mỗi máy | M5 Max (4 cổng TB5, ~3 dùng được cho RDMA*) | M5 Ultra (6 cổng TB5, ~5 dùng được cho RDMA*) |
|---|---|---|---|---|
| 2 máy | 1 | 1 | Đủ | Đủ |
| 3 máy | 3 | 2 | Đủ | Đủ |
| 4 máy | 6 | 3 | Vừa đủ | Đủ, còn dư cổng |
| 5 máy | 10 | 4 | Không đủ | Đủ về số cổng, nhưng chưa thấy thử nghiệm công khai nào |
*(suy ra): lấy tổng số cổng Thunderbolt 5 theo thông số Apple (M5 Max: 4 cổng sau; M5 Ultra: 4 cổng sau + 2 cổng trước) trừ đi cổng cạnh Ethernet mà README exo nói không dùng được cho RDMA trên Mac Studio. Lưu ý này được viết cho thế hệ Mac Studio trước; Namtech sẽ xác nhận lại trên máy M5 thật khi dựng cụm.
Con số trong bảng nói lên một điều thực tế: cụm 2 máy gần như không có rào cản đi dây, còn cụm 4 máy đã là 6 sợi cáp đan chéo, mỗi máy chiếm 3 cổng. Jeff Geerling cũng nhận xét rằng đầu cắm Thunderbolt không giữ chắc bằng cổng QSFP trên hệ thống DGX Spark, và ông không tin mớ dây cắm chéo sẽ bền lâu trong nhiều môi trường. Vì vậy cụm nên đặt ở một vị trí cố định, có kệ hoặc tủ gọn gàng, thay vì để trên bàn làm việc chung.
Ngoài dây, còn vài điều kiện vận hành mà tài liệu nêu rõ. Theo MLX, dù RDMA không dùng TCP/IP, vẫn phải tắt Thunderbolt Bridge và cấu hình mạng cục bộ riêng cho từng kết nối Thunderbolt; công cụ mlx.distributed_config có thể dò cấu trúc dây, kiểm tra cụm hợp lệ và sinh sẵn lệnh cấu hình. Theo exo, các cổng RDMA có thể không nhận ra nhau nếu phiên bản macOS khác nhau, nên mọi máy phải chạy đúng cùng một phiên bản macOS, kể cả số bản beta.
Bật RDMA: chỉ làm được tại chỗ
Đây là điểm khác biệt lớn so với máy chủ thông thường: RDMA qua Thunderbolt không bật được từ xa. Tài liệu MLX viết rằng cho tới khi tính năng trưởng thành hơn, việc bật RDMA không thể làm từ xa kể cả với sudo, mà phải khởi động máy vào chế độ Recovery của macOS, mở Terminal từ menu Utilities, chạy lệnh rdma_ctl enable rồi khởi động lại. Sau đó có thể kiểm tra bằng lệnh ibv_devices. Với cụm 4 máy, nghĩa là bốn lần thao tác trực tiếp trên từng máy — kỹ thuật viên phải có mặt.
Phần mềm: MLX phân tán và exo
Có hai cách chính để chạy mô hình trên cụm Mac hiện nay: dùng thẳng tầng phân tán có sẵn trong MLX, hoặc dùng exo — một lớp phần mềm mã nguồn mở xây trên MLX, tự lo phần phát hiện máy và chia mô hình. Cả hai đều dựa trên cùng nền tảng: README của exo ghi rõ exo dùng MLX làm backend suy luận và MLX distributed cho truyền thông giữa các máy.
MLX phân tán phù hợp khi đội kỹ thuật muốn kiểm soát chi tiết: định nghĩa danh sách máy trong một hostfile JSON, chọn backend (ring, JACCL, MPI…) và chạy bằng mlx.launch. Tài liệu MLX có hướng dẫn cho cả song song dữ liệu lẫn tensor parallelism. Cách này linh hoạt nhưng đòi hỏi người vận hành hiểu cấu hình mạng và phân tán.
exo hướng tới trải nghiệm đơn giản hơn. Theo README, exo tự phát hiện các thiết bị chạy exo mà không cần cấu hình tay, tự chọn cách chia mô hình dựa trên cấu trúc cụm thực tế (tài nguyên từng máy, độ trễ và băng thông từng đường nối), hỗ trợ tensor parallelism với mức tăng tốc tới 1,8 lần trên 2 thiết bị và 3,2 lần trên 4 thiết bị, và tương thích với nhiều kiểu API phổ biến như OpenAI Chat Completions, Claude Messages, OpenAI Responses và Ollama. exo cũng nói có hỗ trợ RDMA qua Thunderbolt 5 ngay từ ngày đầu, giúp giảm 99% độ trễ giữa các thiết bị, và có ứng dụng macOS yêu cầu macOS Tahoe 26.2 trở lên. Jeff Geerling ghi nhận exo 1.0 ra mắt cùng thời điểm bài thử nghiệm của ông (18/12/2025), với tính năng chính là RDMA cho cụm Mac có Thunderbolt 5, phát hành theo giấy phép Apache 2.0.
Một chi tiết cho thấy exo đã được chính Apple ghi nhận: trên trang Mac Studio của Apple (tra ngày 24/09/2026), phần giới thiệu ứng dụng AI có câu mời dùng exo để ghép cụm nhiều máy trạm AI.
| Phương án | Chạy trên | Đường truyền giữa máy | Điểm mạnh | Lưu ý |
|---|---|---|---|---|
| MLX, Ollama, LM Studio | 1 máy | Không cần | Đơn giản nhất, đủ cho đa số nhu cầu nội bộ | Bị giới hạn bởi bộ nhớ của một máy |
| MLX phân tán — backend ring | Cụm | TCP (qua Thunderbolt hoặc Ethernet), nối vòng | Luôn sẵn sàng, không cần bật RDMA | Độ trễ cao hơn JACCL một bậc độ lớn; chỉ giao tiếp với máy kề bên |
| MLX phân tán — backend JACCL | Cụm | RDMA qua Thunderbolt 5, nối đủ mọi cặp | Độ trễ thấp, cần cho tensor parallelism | Bật RDMA tại chỗ trong Recovery; số cáp tăng nhanh theo số máy |
| exo | Cụm | RDMA qua Thunderbolt 5 (qua MLX distributed) | Tự phát hiện máy, tự chia mô hình, API tương thích OpenAI/Ollama | Mọi máy phải cùng phiên bản macOS; không dùng cổng TB5 cạnh Ethernet trên Mac Studio |
Thử nghiệm cụm 4 máy của bên thứ ba nói gì?
Thử nghiệm công khai chi tiết nhất hiện có là của Jeff Geerling, trên 4 Mac Studio M3 Ultra — thế hệ chip cũ hơn M5 Ultra — với tổng 1,5TB bộ nhớ hợp nhất, nối qua RDMA/Thunderbolt 5, máy do Apple cho mượn. Các con số dưới đây là của bên thứ ba, đo trên phần cứng và phần mềm tại thời điểm cuối 2025; chúng cho biết xu hướng, không phải tốc độ của cụm M5 Ultra.
Theo bài của Jeff Geerling, exo nhanh dần khi thêm máy và đạt 32 token/giây với mô hình Qwen3 235B trên cả cụm; với Kimi K2 Thinking — mô hình 1 nghìn tỷ tham số, khoảng 32 tỷ tham số hoạt động mỗi lúc — cụm vẫn đạt khoảng 30 token/giây. Ông cũng thử DeepSeek V3.1 671 tỷ tham số. Đáng chú ý, llama.cpp chia các lớp mô hình qua RPC nên hiệu năng giảm khi thêm máy, trong khi exo — khi đó là công cụ duy nhất hỗ trợ RDMA trong các công cụ ông dùng — lại tăng tốc theo số máy.
Mặt còn lại cũng được ghi rõ. Ông dùng phần mềm tiền phát hành, nhiều lỗi được sửa trong quá trình thử, và nhận xét RDMA qua Thunderbolt còn mới: khi chạy thì chạy rất tốt, khi không chạy thì phải tắt và khởi động lại cả cụm. Chạy HPL qua Thunderbolt (bằng TCP, không RDMA) còn khiến máy treo và tự khởi động lại. Quản trị cụm Mac cũng có vướng mắc riêng, ví dụ không nâng cấp hệ điều hành qua SSH được mà phải bấm trên giao diện. Ông kết luận câu hỏi lớn là doanh nghiệp có thực sự cần cả cụm hay không, vì chỉ một Mac Studio đã rất mạnh.
Gói AI Cluster 2 và AI Cluster 4 của Namtech
Namtech đóng gói hai cấu hình cụm dựa trên cùng một máy nền: Mac Studio M5 Ultra 30 CPU/64 GPU, 256GB. AI Cluster 2 gồm 2 máy, tổng 512GB bộ nhớ hợp nhất; AI Cluster 4 gồm 4 máy, tổng 1TB. Giá phần cứng bên dưới là giá bán Namtech ngày 24/09/2026, đã gồm VAT; phần mềm, triển khai và bảo trì báo giá riêng theo phạm vi từng dự án.
Cột cỡ mô hình là ước lượng dùng để tư vấn chọn cấu hình, cùng công thức với bài chi phí thật chạy LLM on-premise: bộ nhớ dùng được ≈ 75% RAM, mô hình 4-bit ≈ 0,5 byte/tham số, chừa 20% cho ngữ cảnh — áp trên tổng RAM của cụm. Đây là trần lý thuyết về dung lượng, chưa trừ hao phí khi chia mô hình ra nhiều máy, không phải số đo tốc độ.
| Phương án | Tổng RAM | Cỡ mô hình tối đa (4-bit, ước lượng)* | Giá phần cứng | Khi nào nên chọn |
|---|---|---|---|---|
| 1 × M5 Ultra 96GB (gói AI Enterprise) | 96GB | ~115 tỷ tham số | 182.400.000₫ | Toàn doanh nghiệp, trợ lý nội bộ, RAG, mô hình cỡ trung |
| 1 × M5 Ultra 256GB | 256GB | ~307 tỷ tham số | 307.800.000₫ | Cần mô hình lớn nhưng vẫn muốn vận hành đơn giản trong một máy |
| AI Cluster 2 — 2 × M5 Ultra 256GB | 512GB | ~614 tỷ tham số | 615.600.000₫ | Mô hình cần dùng vượt 256GB; chỉ 1 cáp Thunderbolt 5, dễ dựng nhất |
| AI Cluster 4 — 4 × M5 Ultra 256GB | 1TB | ~1.228 tỷ tham số | 1.231.200.000₫ | Mô hình rất lớn (nhóm hàng trăm tỷ đến nghìn tỷ tham số); 6 cáp, cần vị trí đặt cố định |
*Ước lượng của Namtech, không phải benchmark: bộ nhớ dùng được ≈ RAM × 0,75 (phần macOS mặc định cho GPU dùng) trên mỗi máy, mô hình lượng tử 4-bit ≈ 0,5 byte/tham số, chừa 20% cho ngữ cảnh; chưa tính hao phí phân tán. Giá gốc (trước giảm) tương ứng: 192.000.000₫ · 324.000.000₫ · 648.000.000₫ · 1.296.000.000₫. Máy do Công ty Cổ phần Trạm Năng Lượng Số bán và xuất hoá đơn VAT; Namtech tư vấn cấu hình và cài đặt.
Nhìn vào bảng, bước nhảy đáng chú ý nhất không phải từ cụm 2 lên cụm 4, mà từ máy 96GB lên máy 256GB: dung lượng tăng gần gấp ba trong khi vẫn là một máy, không cáp, không bật RDMA, không phải lo đồng bộ phiên bản macOS. Vì vậy với doanh nghiệp đang cân nhắc cụm 2 máy 96GB, hãy so trước với một máy 256GB — xem hai cấu hình cạnh nhau tại trang so sánh Mac.
Về điện năng, bài chi phí của Namtech dẫn số Apple: Mac Studio M5 Ultra tiêu thụ tối đa khoảng 385W cho cả máy. Suy ra cụm 4 máy chạy hết công suất cùng lúc ở mức trần khoảng 1,54 kW (suy ra: 4 × 385W); nên tính trước nguồn điện và bộ lưu điện cho cả cụm khi chọn vị trí đặt. Apple cũng thông báo bản M5 Ultra 512GB sẽ ra mắt cuối tháng 10/2026, chưa công bố giá; khi có, một máy 512GB có thể thay cho cụm 2 máy 256GB với nhiều nhu cầu.
Khi nào KHÔNG cần ghép cụm?
Phần lớn doanh nghiệp không cần cụm. Một Mac Studio M5 Ultra 96GB — ước lượng tới khoảng 115 tỷ tham số ở 4-bit — đã đủ chạy các mô hình mở như Qwen, SEA-LION hay Gemma cho trợ lý nội bộ, hỏi–đáp tài liệu và RAG, qua MLX, Ollama hoặc LM Studio. Máy 256GB mở rộng tới khoảng 307 tỷ tham số, vẫn trong một thân máy. Cụm chỉ thật sự đáng tiền khi mô hình bạn bắt buộc phải dùng lớn hơn thế.
Ba hạn chế cần cân nhắc trước khi quyết. Thứ nhất, số cáp: cụm nối đủ mọi cặp tăng số cáp theo cấp số nhân — 4 máy đã là 6 sợi, và chưa có switch để gom lại. Thứ hai, bật tại chỗ: RDMA chỉ bật được trong Recovery ngay trên từng máy, mọi máy phải cùng phiên bản macOS, nên mỗi lần cài lại hay nâng cấp đều cần kỹ thuật viên có mặt và kế hoạch cập nhật đồng loạt. Thứ ba, hao phí phân tán: các máy phải trao đổi dữ liệu liên tục, nên 4 máy không nhanh gấp 4 — exo công bố tối đa 3,2 lần, Apple nêu tới 3 lần trong phép thử của hãng.
Cũng cần nhớ bài toán mà cụm Mac giải là dung lượng bộ nhớ — nạp được mô hình rất lớn tại chỗ. Nếu nhu cầu thật là phục vụ rất nhiều người dùng đồng thời, xử lý hàng loạt, hay huấn luyện mô hình, hãy xem lại phân tích Apple Silicon và GPU trong bài chọn phần cứng chạy AI nội bộ trước khi chọn cụm.
Namtech dựng cụm Mac Studio thế nào?
Namtech đi theo nguyên tắc đo trước, chốt sau: với mỗi khách hàng cân nhắc AI Cluster, chúng tôi xác định mô hình cần chạy và tải dự kiến, dựng thử và đo trên mô hình đó trước khi chốt cấu hình, và không cam kết một con số tốc độ nào trước khi đo. Nếu kết quả cho thấy một máy 256GB là đủ, chúng tôi sẽ đề xuất một máy.
Khi đi tới cụm, phần việc gồm: bố trí vị trí đặt và đi dây Thunderbolt 5 theo cấu trúc nối đủ mọi cặp, bật RDMA tại chỗ trên từng máy, đồng bộ phiên bản macOS, cấu hình mạng cho từng kết nối, cài MLX phân tán hoặc exo, rồi mở API tương thích OpenAI để các ứng dụng nội bộ dùng như một máy chủ AI duy nhất. Máy do Công ty Cổ phần Trạm Năng Lượng Số bán và xuất hoá đơn VAT; Namtech tư vấn cấu hình, cài đặt và vận hành. Xem toàn bộ cấu hình và giá tại trang Mac Studio.
Ghép cụm Mac Studio qua RDMA/Thunderbolt 5 là cách nạp những mô hình vượt bộ nhớ một máy ngay tại văn phòng, nhưng nó đổi lấy nhiều cáp, thao tác tại chỗ và hao phí phân tán — nên hãy chọn cụm khi mô hình thực sự cần, và đo trước khi mua.
Câu hỏi thường gặp
Ghép nhiều Mac Studio thành một cụm AI để làm gì?
Để chạy những mô hình mở quá lớn cho bộ nhớ của một máy. Các máy nối với nhau qua Thunderbolt 5 và chia nhau phần tính toán; từ macOS 26.2, RDMA qua Thunderbolt giúp độ trễ giữa các máy thấp hơn nhiều so với truyền qua TCP. Với mô hình vừa một máy, một máy thường là lựa chọn đơn giản và hiệu quả hơn.
Cần bao nhiêu cáp Thunderbolt 5 để ghép cụm?
Backend JACCL của MLX chỉ hỗ trợ cấu trúc nối đủ mọi cặp máy, nên số cáp là n(n−1)/2 và mỗi máy cần n−1 cổng: 2 máy cần 1 cáp, 3 máy cần 3 cáp, 4 máy cần 6 cáp. Theo các nguồn đã đọc, hiện chưa có switch Thunderbolt 5 để nối vào một điểm trung tâm.
Có bật RDMA từ xa được không?
Không. Theo tài liệu MLX, RDMA qua Thunderbolt phải bật trong chế độ Recovery của macOS bằng lệnh rdma_ctl enable rồi khởi động lại, và không bật từ xa được kể cả với sudo. Vì vậy mỗi máy trong cụm cần được thao tác tại chỗ khi dựng.
Cụm 4 máy có nhanh gấp 4 lần một máy không?
Không. exo công bố tăng tốc tensor parallel tối đa khoảng 1,8 lần với 2 máy và 3,2 lần với 4 máy; Apple nêu cụm 4 Mac Studio M5 Ultra nhanh hơn tới 3 lần một máy trong phép thử của hãng. Phần hao hụt đến từ việc các máy phải trao đổi dữ liệu với nhau. Namtech dựng thử và đo trên tải thật trước khi chốt, không hứa tốc độ.
Gói AI Cluster 2 và AI Cluster 4 của Namtech giá bao nhiêu?
Phần cứng AI Cluster 2 (2 × Mac Studio M5 Ultra 30 CPU/64 GPU, 256GB) là 615.600.000₫; AI Cluster 4 (4 máy cùng cấu hình) là 1.231.200.000₫, đã gồm VAT, theo giá bán Namtech ngày 24/09/2026. Phần mềm, triển khai và bảo trì báo giá riêng.
Doanh nghiệp nào không cần ghép cụm?
Phần lớn doanh nghiệp. Một Mac Studio M5 Ultra 96GB (ước lượng tới ~115 tỷ tham số ở 4-bit) hoặc 256GB (ước lượng tới ~307 tỷ) đã đủ cho trợ lý nội bộ, hỏi–đáp tài liệu và RAG với các mô hình như Qwen, SEA-LION, Gemma. Chỉ nên ghép cụm khi mô hình cần dùng thực sự vượt quá bộ nhớ một máy.
Cần một máy hay cả cụm? Đo trước rồi hãy quyết
Namtech giúp doanh nghiệp xác định mô hình cần chạy, dựng thử và đo trên Mac Studio, rồi mới đề xuất một máy hay AI Cluster 2 / AI Cluster 4 — cùng phần cài đặt MLX, exo, Ollama hoặc LM Studio và vận hành tại chỗ.
Đặt lịch tư vấn miễn phíLưu ý: Bài viết tổng hợp từ nguồn công khai tra cứu ngày 24/09/2026. Số liệu tốc độ của cụm M3 Ultra là của bên thứ ba (Jeff Geerling, 12/2025) trên thế hệ chip cũ, không đại diện cho cụm M5 Ultra; số “3 lần” là phép thử của Apple trong điều kiện của hãng. Cỡ mô hình là ước lượng theo dung lượng bộ nhớ, không phải benchmark. Giá máy là giá bán Namtech đã gồm VAT tại 24/09/2026 và thay đổi theo giá niêm yết của Apple. Thông tin tham khảo, không phải tư vấn kỹ thuật hay đầu tư.
- MLX — Distributed Communication (RDMA qua Thunderbolt từ macOS 26.2, backend JACCL/ring, rdma_ctl enable trong Recovery, yêu cầu nối đủ mọi cặp) — tra ngày 24/09/2026
- exo-explore/exo trên GitHub — README (RDMA qua Thunderbolt 5, tensor parallel 1,8×/3,2×, lưu ý cổng và phiên bản macOS) — tra ngày 24/09/2026
- Jeff Geerling — 1.5 TB of VRAM on Mac Studio: RDMA over Thunderbolt 5 (18/12/2025) — tra ngày 24/09/2026
- MacRumors — New Mac Studio Can Be Clustered Together for Faster AI Performance (26/08/2026) — tra ngày 24/09/2026
- Apple — Trang Mac Studio (giới thiệu exo, chú thích phép thử cụm 4 máy) và trang thông số Mac Studio (số cổng Thunderbolt 5) — tra ngày 24/09/2026
- Apple Newsroom — Apple introduces new Mac Studio with M5 Max and M5 Ultra (08/2026) — tra ngày 24/09/2026