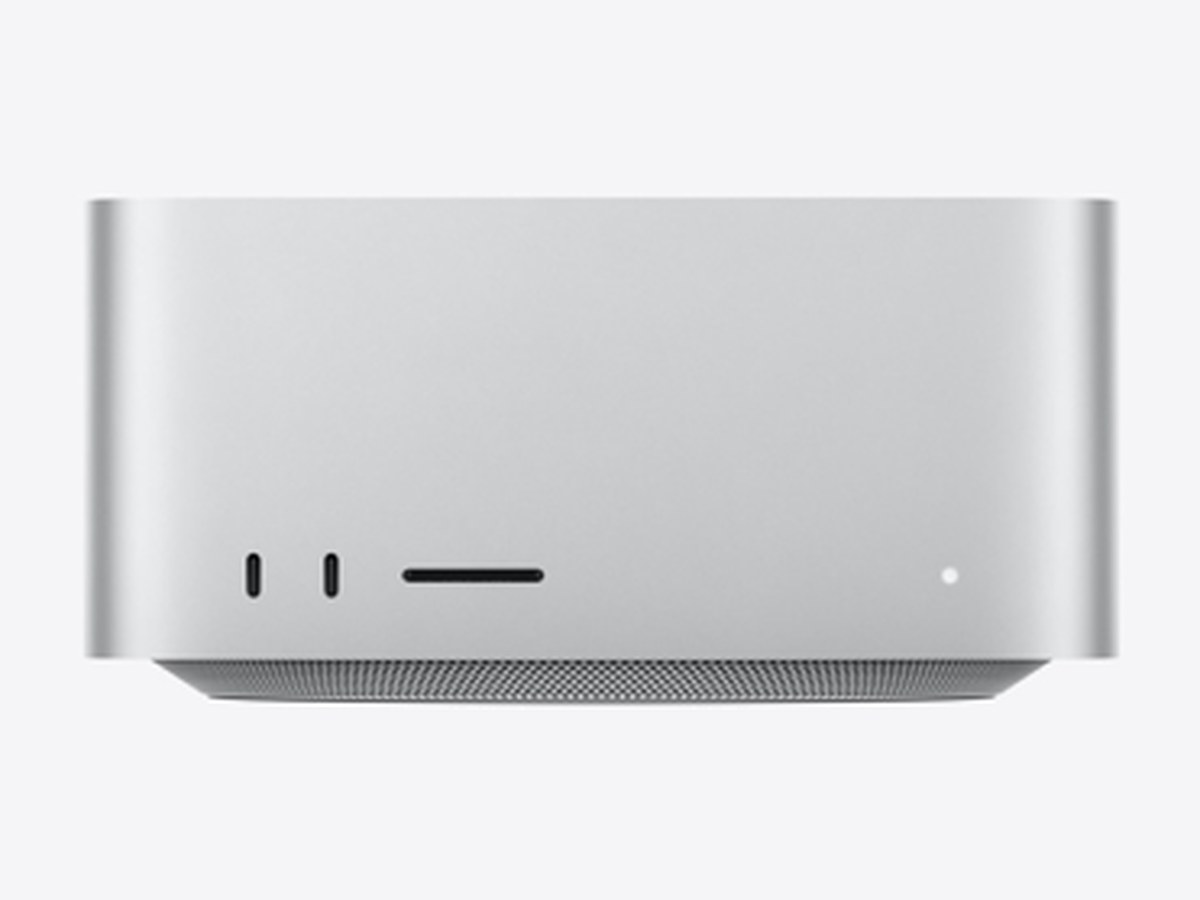
Ghép nhiều Mac Studio thành cụm chạy AI nội bộ: RDMA qua Thunderbolt 5, MLX và exo
Cụm Mac Studio chạy AI nội bộ: RDMA qua Thunderbolt 5 từ macOS 26.2, MLX phân tán và exo, cần bao nhiêu cáp, so sánh một máy với cụm và khi nào một máy là đủ.
Đọc tiếp →
AI nội bộ suy luận thế nào để trả kết quả đúng như Claude?
Cùng nguyên lý dự đoán token trên nền transformer, được RAG neo vào tài liệu của bạn, suy luận từng bước — và câu trả lời trung thực cho câu hỏi 'có bằng Claude không?'.
Đọc tiếp →
Chọn mô hình mã nguồn mở & giấy phép thương mại
Các họ model phổ biến, giấy phép thương mại khác nhau ra sao, chọn cỡ nhỏ nhất đủ dùng, và cách thử ứng viên cho AI nội bộ.
Đọc tiếp →
Đánh giá chất lượng & tinh chỉnh AI nội bộ (eval, guardrails)
Đo chất lượng bằng golden set, giảm ảo giác bằng RAG + trích dẫn, đặt guardrails, và khi nào cần fine-tune.
Đọc tiếp →
Giao diện chat & tích hợp AI nội bộ vào quy trình
Giao diện chat cho nhân viên, API tương thích OpenAI để nối vào helpdesk/CRM, xác thực SSO & phân quyền — tất cả on-premise.
Đọc tiếp →
Hệ thống bảo mật của AI nội bộ: các lớp phòng thủ
Các lớp phòng thủ theo chiều sâu cho AI nội bộ — cô lập mạng, RBAC, mã hóa, audit log, chống prompt injection, PII, quản lý bí mật, an ninh vật lý.
Đọc tiếp →
Mô hình AI mở dùng thương mại được: Mỹ, Trung Quốc, Châu Âu — benchmark và thế mạnh từng model
gpt-oss, Gemma 4, Muse Glimmer, Qwen3.8, DeepSeek V4.1, GLM-5.3, Kimi K3, Mistral: license nào dùng thương mại được, điểm benchmark độc lập so với GPT, Claude, Gemini, và chọn model theo RAM Mac Studio / Mac mini.
Đọc tiếp →
Phần cứng chạy AI nội bộ on-premise: chọn thế nào?
Apple Silicon hay GPU, quy tắc bộ nhớ theo cỡ mô hình, và cách sizing AI Box / AI Pro / AI Enterprise theo quy mô.
Đọc tiếp →
RAG: cho AI nội bộ học tài liệu nội bộ của bạn
Cho AI nội bộ đọc tài liệu nội bộ và trả lời kèm trích dẫn: pipeline RAG, vector DB, embedding đa ngữ và chunking.
Đọc tiếp →
Serving: cài & tối ưu tốc độ chạy mô hình AI nội bộ
Chọn Ollama, vLLM hay llama.cpp; quantization; batching; API tương thích OpenAI cho AI nội bộ.
Đọc tiếp →
Sơ đồ kiến trúc hệ thống AI nội bộ (giải thích từng lớp)
Kiến trúc AI nội bộ on-premise giải thích từng lớp, kèm sơ đồ luồng dữ liệu của một câu hỏi.
Đọc tiếp →
Sơ đồ phòng ban & phân quyền khi triển khai AI nội bộ
Sơ đồ phòng ban dùng AI nội bộ và cách phân quyền (RBAC) để mỗi phòng chỉ thấy tài liệu được phép — kèm phân quyền ở tầng RAG.
Đọc tiếp →
Token AI là gì? Đơn vị dữ liệu & cửa sổ ngữ cảnh của AI
Token là đơn vị nhỏ nhất mô hình AI đọc và sinh ra. Hiểu token, tokenization, cửa sổ ngữ cảnh và mối liên hệ với chi phí AI.
Đọc tiếp →
Trending Pool: cách AI nội bộ cập nhật tri thức toàn cầu định kỳ
Cơ chế cập nhật tri thức định kỳ qua kênh có kiểm soát — giúp AI nội bộ luôn mới mà vẫn giữ cô lập, không mở internet trực tiếp.
Đọc tiếp →
Tự xây AI nội bộ: vì sao & lộ trình tổng quan (8 bước)
Vì sao nên tự xây AI nội bộ, so sánh với AI cloud, và lộ trình 8 bước từ phần cứng tới vận hành.
Đọc tiếp →
Vận hành, giám sát & mở rộng AI nội bộ
Giám sát, sao lưu, cập nhật mô hình và nâng gói AI Box → AI Pro → AI Enterprise — bước 8/8 của series tự xây AI nội bộ.
Đọc tiếp →
"Năm chủ quyền AI": EU AI Act siết luật, vì sao doanh nghiệp Việt nên giữ dữ liệu tại chỗ
EU AI Act lùi nghĩa vụ AI rủi ro cao sang 12/2027 và 08/2028, phạt tới 7% doanh thu toàn cầu. Vì sao doanh nghiệp nên cân nhắc AI nội bộ on-premise.
Đọc tiếp →
15 plugin JetBrains giả mạo đánh cắp API key AI của ~70.000 developer: bài học chuỗi cung ứng
Plugin giả dạng AI assistant trên JetBrains Marketplace đánh cắp key OpenAI/DeepSeek. JetBrains gỡ 17/06. Bài học supply-chain cho doanh nghiệp.
Đọc tiếp →
Anthropic ra mắt Claude Sonnet 5: hiệu năng cận flagship, 1 triệu token context, giá khuyến mãi $2/$10
Model tầm trung agentic của Anthropic (30/06): default cho Free/Pro, 1M token context mặc định, giá $2/$10 per Mtok (nay là giá chính thức).
Đọc tiếp →
Bạn vừa tải mô hình mở nào về vậy? Cisco mở kho tra xuất xứ gần 900 mô hình — và một chuẩn định nghĩa thế nào là "dẫn xuất"
Cisco mở kho tra xuất xứ gần 900 mô hình mở và một chuẩn định nghĩa thế nào là dẫn xuất. Với doanh nghiệp chạy AI nội bộ, đây là câu hỏi phải trả lời trước khi nạp mô hình.
Đọc tiếp →
ChatGPT có "trợ lý tự động" mới: lên lịch nhắc việc, theo dõi web và app thay bạn
OpenAI ra mắt Scheduled Tasks trong ChatGPT — đặt nhắc nhở, công việc lặp lại và tác vụ theo dõi web/app tự động.
Đọc tiếp →
Chi phí thật để tự chạy LLM on-premise 2026: VRAM, GPU hay Mac Studio, và tiền điện
Bài toán TCO cho doanh nghiệp Việt: VRAM theo mô hình mở, tiền điện GPU và Mac Studio theo giá điện chính thức, giá máy 3 gói AI nội bộ, so sánh với cloud API.
Đọc tiếp →
Chọn vector database cho RAG nội bộ 2026: pgvector, Qdrant, Milvus, Weaviate, Chroma — so giấy phép, phiên bản & dung lượng
Cẩm nang chọn công cụ: so 5 vector database mã nguồn mở theo giấy phép, phiên bản, dung lượng vector, và cách chọn mô hình embedding đa ngữ cho tiếng Việt.
Đọc tiếp →
DeepSeek ra mắt bản xem trước V4: mô hình mã nguồn mở "thu hẹp khoảng cách" với các mô hình hàng đầu
V4-Pro & V4-Flash mã nguồn mở, ngữ cảnh 1 triệu token — DeepSeek tuyên bố thu hẹp khoảng cách với các mô hình tiên phong.
Đọc tiếp →
EU hoãn quy định AI rủi ro cao tới 12/2027 (Digital Omnibus): doanh nghiệp Việt đừng ngủ quên
EU hoãn nghĩa vụ với hệ thống AI rủi ro cao (Annex III) sang 02/12/2027, nhưng khung phạt tới 35 triệu EUR/7% doanh thu vẫn còn nguyên. Doanh nghiệp Việt cần làm gì.
Đọc tiếp →
EU ra Kế hoạch Hành động An ninh mạng & AI (07/07/2026): khi AI vừa là vũ khí vừa là lá chắn — doanh nghiệp Việt đọc thế nào?
Ủy ban châu Âu công bố 07/07/2026: đánh giá mô hình AI trước khi vào thị trường, Blueprint truy cập, nền tảng thử nghiệm an toàn — và bài học cho doanh nghiệp Việt.
Đọc tiếp →Gemini 3.5 Flash ra mắt tại Google I/O 2026: bản Flash vượt cả Pro thế hệ trước về coding và AI agent
Gemini 3.5 Flash — model mặc định cho lập trình và AI agent, vượt Gemini 3.1 Pro trên loạt benchmark, nhanh hơn và rẻ hơn nhiều.
Đọc tiếp →
Gemini 3.6 Flash: token rẻ hơn 17%, nhưng vùng xử lý ML vẫn chỉ có endpoint global — doanh nghiệp Việt đọc thế nào?
Google phát hành Gemini 3.6 Flash ngày 21/07/2026: output $7,50/1M token (giảm từ $9,00) và ít hơn 17% token. Đổi lại: trang model chưa liệt kê vùng ML processing nào.
Đọc tiếp →
Getty Images bắt tay OpenAI: ảnh bản quyền lên thẳng ChatGPT, cổ phiếu Getty tăng vọt
Thỏa thuận hiển thị nhiều năm — ảnh Getty xuất hiện trong ChatGPT (không phải training). Cổ phiếu Getty tăng vọt.
Đọc tiếp →
GLM-5.2: mô hình mở mạnh nhất thế giới (tại thời điểm 24/07/2026) giờ mang giấy phép MIT — và nó thay đổi bài toán AI nội bộ cho doanh nghiệp Việt
Mô hình frontier tự host được, MIT, ngữ cảnh 1 triệu token — và nó thay đổi bài toán AI nội bộ, chủ quyền dữ liệu cho doanh nghiệp Việt.
Đọc tiếp →
Google ra Nano Banana 2 Lite: tạo ảnh AI trong 4 giây, $0.034 cho 1.000 ảnh
Gemini 3.1 Flash-Lite Image (30/06): model tạo ảnh nhanh & rẻ nhất của Google cho doanh nghiệp volume lớn.
Đọc tiếp →
GPT-5.6 ra mắt kiểu chưa từng có: chính phủ Mỹ duyệt từng khách hàng được dùng model mạnh nhất
OpenAI công bố Sol/Terra/Luna (26/06) — giai đoạn đầu chỉ ~20 đối tác được chính phủ Mỹ duyệt mới dùng được Sol. Tiền lệ mới về kiểm soát AI.
Đọc tiếp →
Grok 4.3 của xAI lên Amazon Bedrock: cửa sổ ngữ cảnh 1 triệu token, suy luận tùy chỉnh cho doanh nghiệp
Grok 4.3 lên AWS Bedrock với cửa sổ ngữ cảnh 1 triệu token và mức suy luận cấu hình được — hướng tới workload doanh nghiệp.
Đọc tiếp →
LLM chủ quyền trên máy chủ nội bộ: vì sao 2026 là năm doanh nghiệp "kéo AI về nhà"
Bàn giao LLM chủ quyền on-premise cho một nhà mạng (1/7/2026), số liệu IBM về chi phí rò rỉ do shadow AI, và khung luật dữ liệu Việt Nam đang hội tụ thành một xu hướng.
Đọc tiếp →
Lỗi OpenAI Codex CLI âm thầm bào mòn SSD: ghi ~640 TB/năm, ổ cứng cạn tuổi thọ trong chưa đầy 1 năm
Codex CLI ghi log quá mức (~37 TB/21 ngày ≈ 640 TB/năm) — đủ cạn tuổi thọ SSD 1TB trong chưa đầy 1 năm. Nguyên nhân, bản vá và cách khắc phục.
Đọc tiếp →
MCP bỏ session: bản spec 28/07/2026 biến agent nội bộ thành thứ nhân bản được — và danh sách phải sửa trước khi nâng
MCP chuyển từ giao thức stateful hai chiều sang request/response stateless. Server nội bộ chạy được sau load balancer round-robin thường — đổi lại, đây là bản gãy tương thích.
Đọc tiếp →
Microsoft đưa xử lý Copilot về trong biên giới 15 nước — vì sao "chủ quyền dữ liệu" đang đẩy doanh nghiệp về phía AI nội bộ
Microsoft mở rộng xử lý Microsoft 365 Copilot ngay trong biên giới 15 quốc gia. Chủ quyền dữ liệu đã thành yêu cầu chính thống — và vì sao AI nội bộ / on-premise là mức kiểm soát cao nhất.
Đọc tiếp →
Microsoft ra mắt "Microsoft IQ" tại Build 2026: lớp ngữ cảnh cho AI agent trên Copilot, Foundry và Copilot Studio
Microsoft IQ — lớp ngữ cảnh giúp AI agent hiểu cả kiến thức thế giới lẫn dữ liệu nội bộ. GA trên Copilot, Foundry và Copilot Studio.
Đọc tiếp →
Microsoft tự xây 7 model "MAI" tại Build 2026: bớt phụ thuộc OpenAI, gom Copilot thành "super app"
7 model tự phát triển cho coding/reasoning/image/voice + Copilot 'super app' — Microsoft giảm phụ thuộc OpenAI.
Đọc tiếp →
Mistral ra mắt Mistral Small 4: gộp suy luận, đa phương thức và lập trình vào một mô hình mã nguồn mở
Mistral Small 4 — MoE 119B (6B active), ngữ cảnh 256k, Apache 2.0, gộp suy luận + đa phương thức + agent lập trình; chạy được trên ~4× H100.
Đọc tiếp →
Moonshot ra mắt Kimi K3: mô hình mở 2,8 nghìn tỷ tham số lớn nhất thế giới — bám sát Claude Fable 5 và GPT-5.6 Sol
Context 1 triệu token, benchmark bám sát Claude Fable 5 và GPT-5.6 Sol, giá rẻ bằng 1/3 — weights mở từ 27/07/2026.
Đọc tiếp →
Mỹ buộc Anthropic gỡ Fable 5 toàn cầu: chuyện gì đã xảy ra và bài học cho doanh nghiệp Việt
Fable 5 & Mythos 5 bị gỡ toàn cầu sau lệnh chính phủ Mỹ — rủi ro của việc phụ thuộc AI cloud nước ngoài.
Đọc tiếp →
Nghị định 142/2026 hướng dẫn Luật Trí tuệ nhân tạo — doanh nghiệp cần biết gì
NĐ 142/2026/NĐ-CP (hiệu lực 01/05/2026): phân loại rủi ro AI 3 mức, đánh giá sự phù hợp, sandbox, quỹ hỗ trợ. Doanh nghiệp cần chuẩn bị gì.
Đọc tiếp →
NVIDIA ra mắt siêu chip RTX Spark: đưa AI agent và LLM khổng lồ chạy thẳng trên PC cá nhân
RTX Spark — superchip CPU+GPU đưa LLM tới 120 tỷ tham số và AI agent chạy ngay trên PC cá nhân, không cần cloud.
Đọc tiếp →
NVIDIA ra nền tảng Vera Rubin: dàn chip mới cho kỷ nguyên "AI factory" và agent tự chủ
Loạt chip mới của Vera Rubin phủ từ huấn luyện tới suy luận agentic — nền tảng để doanh nghiệp tự dựng hạ tầng AI.
Đọc tiếp →
OpenAI khai tử GPT-5.2, chuyển sang GPT-5.5 và thêm "Active sessions": vòng đời model ngày càng ngắn
Vòng đời model AI ngày càng ngắn: GPT-5.2 nghỉ, hội thoại chuyển sang GPT-5.5. Bài học ổn định cho doanh nghiệp.
Đọc tiếp →
OpenAI ra chip AI đầu tiên "Jalapeño" cùng Broadcom: thiết kế 9 tháng, nhắm giảm mạnh chi phí inference
ASIC inference đầu tiên do OpenAI thiết kế (24/06) — tape-out 9 tháng, deploy cuối 2026. Cuộc đua tự chủ phần cứng AI.
Đọc tiếp →Perplexity ra mắt "Brain": bộ nhớ AI tự học qua đêm, giúp agent Computer giỏi hơn
Brain dựng 'context graph' sống về việc agent đã làm, qua đêm tổng hợp thành 'LLM wiki' để agent tự cải thiện — Research Preview cho gói Max & Enterprise Max.
Đọc tiếp →
Rò rỉ chatbot AI 2026: từ Lilli của McKinsey đến 300 triệu tin nhắn Chat & Ask AI — vì sao AI nội bộ là lối thoát
Hai vụ lộ dữ liệu chatbot AI lớn của 2026 — đều do hạ tầng cấu hình sai, không phải lỗi mô hình. Vì sao AI nội bộ on-premise là lối thoát.
Đọc tiếp →
ServiceNow lộ dữ liệu khách hàng do endpoint cấu hình sai: bài học kiểm soát dữ liệu nhạy cảm
Một lỗi cấu hình khiến dữ liệu bị truy cập vượt quyền — nền tảng SaaS lớn vẫn rò rỉ. Bài học kiểm soát dữ liệu nhạy cảm.
Đọc tiếp →
Tạm biệt Llama mở: Meta ra mắt Muse Spark — mô hình AI độc quyền đầu tiên của 'phòng lab siêu trí tuệ'
Meta Superintelligence Labs ra mắt Muse Spark theo hướng độc quyền, tạm rời truyền thống mã nguồn mở của dòng Llama.
Đọc tiếp →
Triển khai AI nội bộ mất bao lâu? Lộ trình 8–10 tuần, phía khách phải cử ai, và sáu biến số quyết định về đích đúng hạn
Không có một con số đúng cho mọi doanh nghiệp. Nhưng có một lộ trình đọc được: 5 giai đoạn, 8–10 tuần, và sáu biến số quyết định bạn nằm ở đầu hay cuối khoảng đó.
Đọc tiếp →
Từ pilot lên production: tháng 7/2026, tiền của AI doanh nghiệp đang chảy về hai chỗ — cây cầu ra sản xuất và biên giới dữ liệu
Ba thông cáo tháng 7/2026 cho thấy tiền AI doanh nghiệp đang chảy về hai chỗ: cây cầu đưa pilot ra sản xuất, và hạ tầng giữ dữ liệu trong biên giới.
Đọc tiếp →
wp2shell: lỗ hổng WordPress core bị khai thác thực tế — chain 2 CVE, vá 6.9.5 / 7.0.2 ngay
Chuyện gì đã xảy ra 17–20/07/2026, chain hai CVE hoạt động thế nào, ai dính, và checklist doanh nghiệp Việt phải chạy trong 24 giờ.
Đọc tiếp →
xAI đưa Grok lên Databricks: agent AI suy luận thẳng trên dữ liệu nội bộ doanh nghiệp
Grok có sẵn natively trên Databricks (18/06) — agent suy luận trên dữ liệu Lakehouse, không đẩy ra pipeline ngoài.
Đọc tiếp →